ChatGPT no conoce tu empresa: qué es RAG y cómo lo resuelve
RAG busca primero en tus propios documentos y responde con esa fuente citada. Qué hace falta para montarlo, qué cuesta y cuándo no vale la pena.
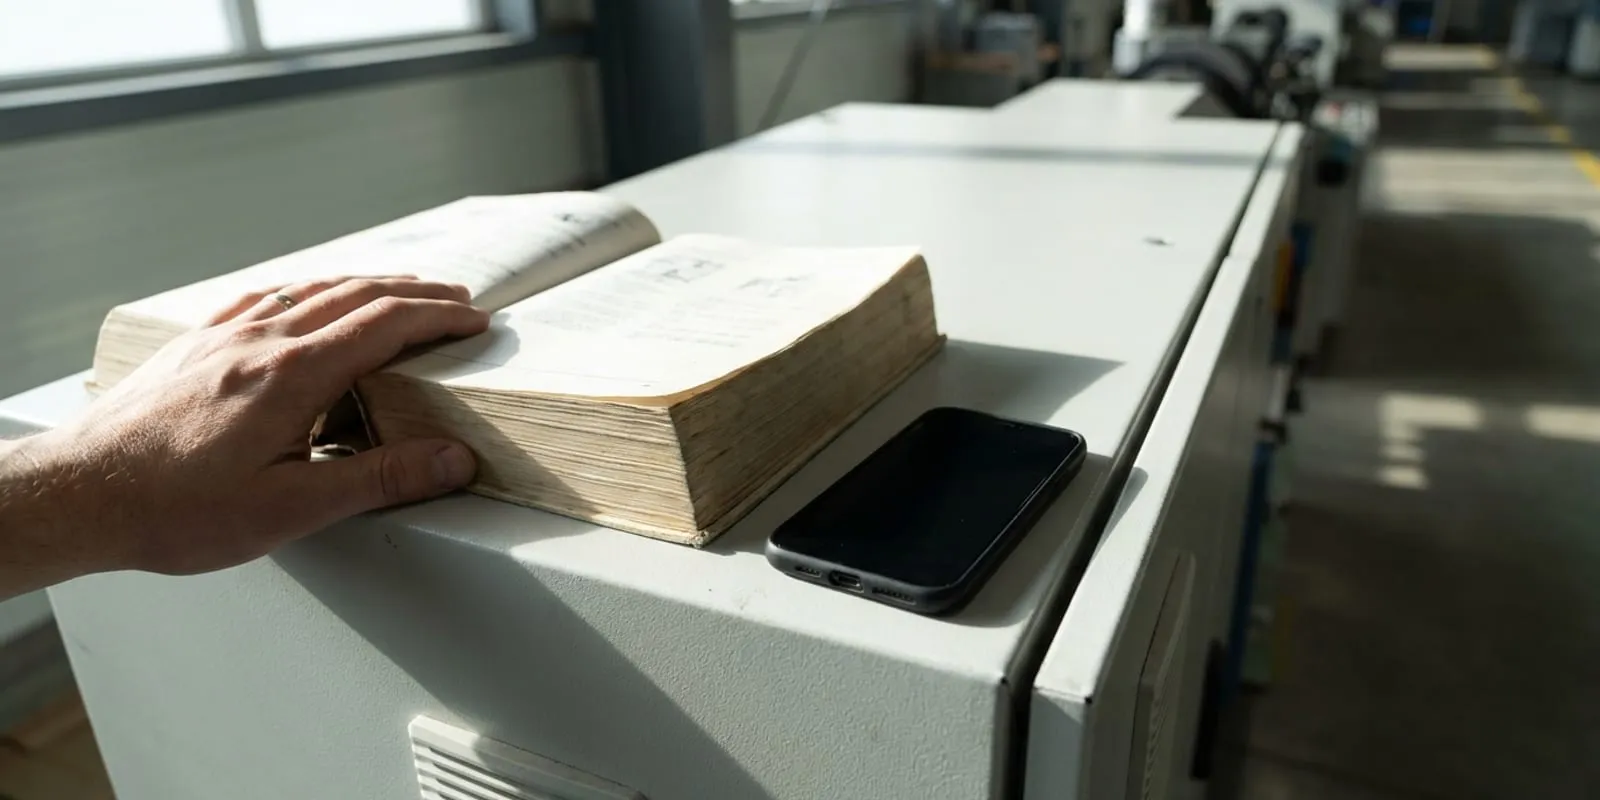
La queja es exacta y la respuesta es que claro que no: un modelo de lenguaje aprendió de textos públicos y tus procedimientos internos no están ahí. Preguntarle por la política de garantía de tu empresa es pedirle que adivine, y cuando adivina, lo hace con mucha seguridad.
RAG es la forma estándar de arreglar eso, y no es magia: es buscar primero en tus documentos y responder solo con lo que encontró, citando de dónde salió. Abajo va qué hace falta, qué cuesta y en qué casos no vale la pena. Primero, el caso.
Preguntas que viven en documentos
Tres técnicos llamando al jefe para preguntar qué cubre la garantía
Catorce años de manuales, fichas técnicas y cartas de garantía en PDF
Una distribuidora de equipos industriales con servicio técnico propio. La información de cada equipo vive en manuales del fabricante, fichas técnicas y cartas de garantía, acumulados en una carpeta compartida con años de antigüedad. Los técnicos salen a campo con esa carpeta en el celular.
La respuesta existía, y nadie la encontraba estando en casa del cliente
Un técnico frente al equipo necesitaba saber si una pieza entraba en garantía o qué par de torque llevaba un tornillo. Buscar en cuarenta PDF desde el celular no es viable, así que llamaban al jefe técnico. Él contestaba de memoria, y a veces la memoria era de la versión anterior del manual.
Un asistente que responde solo con el manual y dice de qué página salió
Se montó un asistente sobre esos documentos, al que se le pregunta en lenguaje normal y responde con la cita: documento, versión y página. Dos decisiones importaron más que el modelo. Una, que si no encuentra la respuesta diga que no la encuentra. Dos, que los documentos vencidos salieran del índice, porque la mitad del problema eran versiones viejas.
El técnico resuelve en campo, y la cita es lo que lo hace confiable
Las llamadas al jefe técnico bajaron, pero lo que hizo que los técnicos lo usaran fue la cita: pueden abrir la página y comprobarlo ellos mismos. Un asistente sin fuente no se habría usado dos semanas, porque nadie se juega una garantía con algo que no puede verificar.
¿Por qué un modelo no sabe nada de tu empresa?
Porque aprendió de texto público y tus documentos no son públicos. Eso no se arregla con un modelo más grande ni con una suscripción mejor: la información no está adentro.
Lo que hace que el problema sea peor de lo que parece es la forma de fallar. Si le preguntas a un modelo por la política de garantía de tu empresa, no te dice que no la conoce. Te da una respuesta plausible, bien redactada, construida con lo que suelen decir las políticas de garantía del mundo. Para un técnico en casa de un cliente, eso es peor que no tener nada.
¿Qué hace RAG, en concreto?
Cambia el orden. En lugar de pedirle al modelo que responda de memoria, el sistema primero busca en tus documentos los fragmentos que tratan de la pregunta, y después le pide al modelo que redacte una respuesta usando solo esos fragmentos, citándolos.
Las piezas son cuatro y ninguna es exótica:
- Partir los documentos en fragmentos con sentido, no por cantidad de caracteres. Un procedimiento cortado a la mitad produce respuestas a la mitad.
- Indexarlos para poder buscarlos por significado y no solo por palabra exacta, con lo que se llaman embeddings. En una pyme esto cabe perfectamente en una base PostgreSQL con pgvector, sin contratar nada nuevo.
- Recuperar los fragmentos relevantes cuando llega la pregunta.
- Responder con la fuente citada, y decir que no se sabe cuando no hay fragmento que conteste.
El cuarto punto es el que separa un asistente útil de una demostración bonita. Un asistente que siempre tiene algo que decir es un asistente en el que no se puede confiar.
¿Qué preguntas conviene mandarle y cuáles no?
Esta tabla es la que más discusiones nos ha ahorrado al principio de un proyecto.
| Tipo de pregunta | ¿RAG? | Por qué |
|---|---|---|
| “¿Qué cubre la garantía del modelo X?” | Sí | La respuesta está escrita en un documento |
| “¿Cuál es el procedimiento si llega un equipo dañado?” | Sí | Igual, y además se cita el procedimiento |
| “¿Cuánto le vendimos a este cliente este año?” | No | Eso es una consulta a la base de datos, y debe ser exacta |
| “¿Cuántas unidades hay en bodega?” | No | Dato vivo del sistema, no documento |
| “¿Qué dice esta factura escaneada?” | No exactamente | Eso es extracción de documentos, otro trabajo |
Las dos filas del medio son el error más común: montar un asistente de lenguaje para contestar un número que una consulta devuelve exacta. Un modelo puede equivocarse al sumar; una consulta no. Si la pregunta tiene una respuesta numérica única, va al sistema y no al modelo.
Y la última fila es un trabajo distinto, que es leer documentos para sacar campos estructurados. Eso está contado en extracción con IA de facturas y documentos.
¿Qué hace falta de tu lado?
Aquí está el trabajo real del proyecto, y casi nada de esto es técnico.
Documentos vigentes y una forma de saber cuáles. Es el requisito que hunde más proyectos. Si en la carpeta compartida conviven tres versiones del mismo procedimiento, el asistente va a citar cualquiera de las tres con la misma seguridad. Antes de indexar hay que decidir quién manda.
Permisos claros. Si hay documentos que no todo el mundo debe ver, el asistente tiene que respetar eso. Un buscador interno que de pronto le muestra la política salarial a toda la empresa es un incidente, no una función.
Alguien que mantenga el índice. Cuando se actualiza un manual, el índice se actualiza. Es poco trabajo y tiene que tener dueño.
En cuanto al costo del modelo, hoy es la parte barata y pública: se puede calcular con las páginas de precios de Anthropic y OpenAI, consultadas el 27 de octubre de 2026. Para el volumen de preguntas de una pyme, el consumo mensual suele ser menor que una licencia de software cualquiera.
¿Cuándo no vale la pena?
Lo decimos seguido y perdemos proyectos con esto. Si lo que tienes son diez preguntas frecuentes que caben en una página, no hace falta RAG: hace falta esa página, bien escrita, donde la gente la encuentre. Montar un asistente para eso agrega costo y una forma nueva de equivocarse.
Tampoco vale la pena cuando los documentos están desactualizados y nadie va a ordenarlos. En ese caso el proyecto no es de inteligencia artificial, es de poner orden, y el asistente viene después.
Si la pregunta llega por WhatsApp, lo que conviene es combinar: el estado de un pedido se contesta desde el sistema y lo que vive en documentos se contesta con RAG. Eso está en WhatsApp Business API. Lo que automatizamos con IA está en automatización e inteligencia artificial.
Lo que conviene recordar
- Un modelo no conoce tu empresa, y cuando no sabe, no se calla: inventa con seguridad.
- RAG invierte el orden: primero busca en tus documentos, después redacta, y siempre cita.
- La cita es lo que hace que la gente lo use. Sin fuente verificable, nadie arriesga una decisión.
- Las preguntas con respuesta numérica exacta van al sistema, no al modelo.
- Si los documentos están desordenados, el proyecto es de orden y no de IA. Y para diez preguntas frecuentes, escribe la página.
Preguntas frecuentes
Si tu caso no encaja en ninguna, escríbenos y lo vemos.
¿Qué es RAG, en una frase?
Buscar primero en tus propios documentos y pedirle al modelo que responda usando solo lo que encontró, citando la fuente. Las siglas son de recuperación aumentada por generación, y lo importante es el orden: primero se busca, después se redacta.
¿Por qué no basta con subir los documentos a un chat?
Funciona para un puñado de archivos y se cae con un volumen real. Un asistente montado bien busca entre miles de documentos, respeta permisos, se actualiza cuando cambia un archivo y cita la fuente. Un chat con adjuntos no hace ninguna de esas cuatro cosas.
¿Puede inventar respuestas?
Puede, y por eso el diseño importa más que el modelo. Se le instruye a responder solo con lo recuperado y a decir que no sabe cuando no encuentra, y se muestra siempre la cita. Si la respuesta no trae fuente verificable, el asistente no está listo para producción.
¿Qué documentos sirven y cuáles no?
Sirven los que son texto: manuales, procedimientos, contratos, correos, fichas. Dan problemas los PDF escaneados sin texto, que primero necesitan reconocimiento óptico, y las hojas de cálculo grandes, donde una pregunta de cálculo se responde mejor consultando la base de datos.
¿Cuánto cuesta mantenerlo?
Menos de lo que la gente supone en consumo del modelo, y más de lo que supone en mantenimiento de los documentos. El gasto que importa no es el técnico: es que alguien se ocupe de que lo indexado sea la versión vigente. Un asistente sobre documentos viejos responde mal con total seguridad.
¿Esto te está pasando?
Cuéntanos tu caso y te decimos si tiene solución y cuánto trabajo implica, sin costo.
Hablar por WhatsAppSeguir leyendo
Avisarle al cliente en qué va su pedido, automáticamente
El aviso sale cuando el sistema cambia de estado, no cuando alguien se acuerda. Qué eventos avisar, cuáles callar y cómo no mandar el mismo tres veces.
Leer →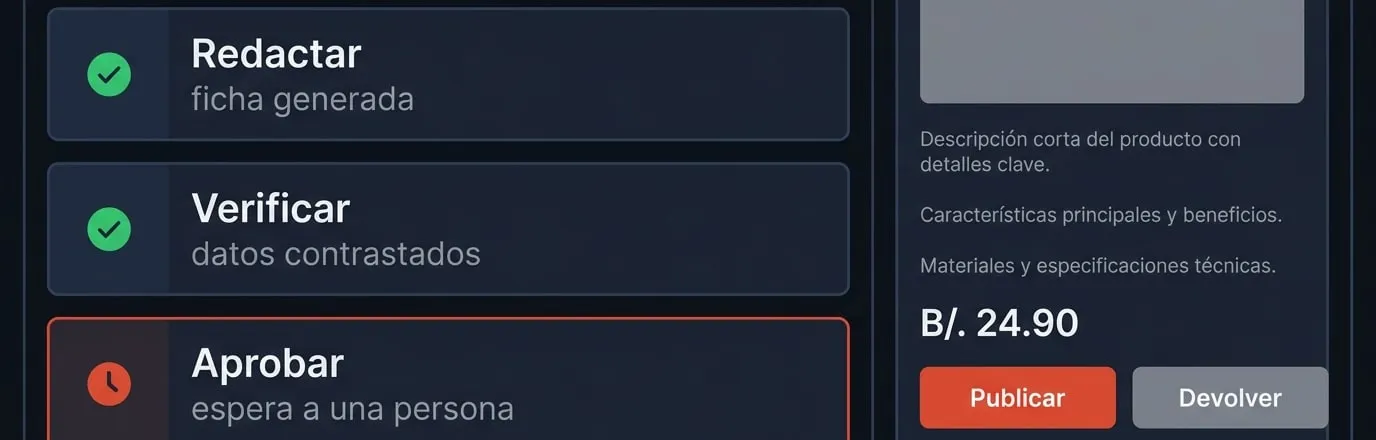
¿Puede la IA llenar tu catálogo sin que nadie lo revise?
Técnicamente sí, y no es lo que hicimos. Cómo se encadenan agentes para investigar, redactar y publicar productos, y en qué punto exacto entra una persona.
Leer →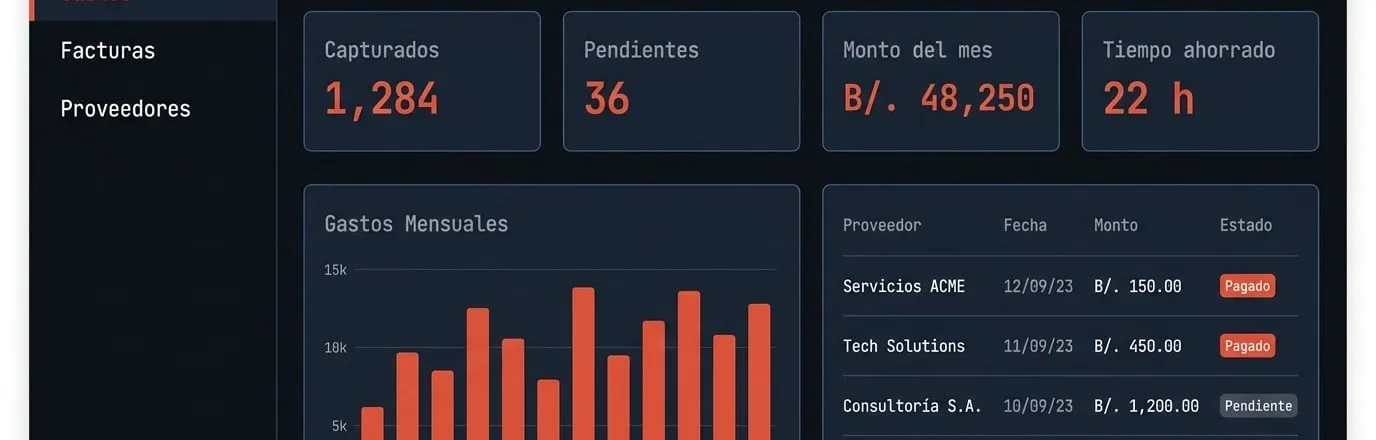
Cómo dejar de capturar gastos y facturas a mano en QuickBooks
Seis sucursales en Panamá mandaban doce archivos de Excel al día y alguien los teclaba en QuickBooks. Cómo se automatiza sin cambiar de sistema contable.
Leer →